

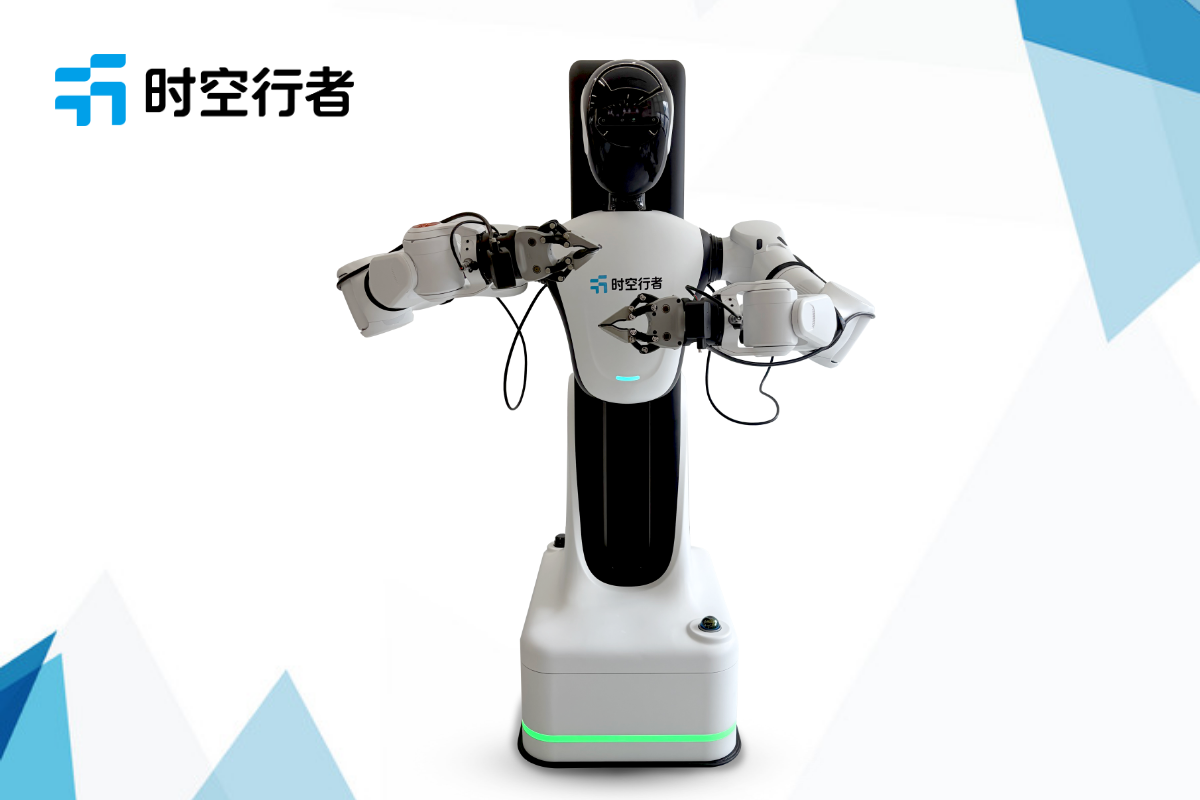
行者 R1 Pro 轮式双臂机器人 具身智能感知交互实验平台
具身智能区别于纯文本、图像大模型的关键,在于机器人能够依靠多种感官感知物理世界,并且基于感知结果做出物理交互动作。单一视觉信息存在遮挡、反光、尺度歧义;单纯激光点云缺少纹理语义;只有力反馈无法识别目标物体。视觉、深度、激光、力觉、语音多模态信息融合,才能让机器人建立对环境、物体、接触状态的完整理解,实现更加鲁棒的交互行为。
很多科研平台传感器是零散加装,时间戳不同步、坐标系不统一,数据对齐工作消耗巨大,很难开展高质量的多模态融合实验。行者 R1 Pro 从硬件布线、底层驱动、ROS 消息链路层面统一设计感知系统,实现多传感器高精度时序同步,打造感知采集、融合推理、物理交互一体化的真机实验载体。
一、多模态感知融合,是具身智能理解真实世界的核心入口
真实室内环境充满不确定性:物体被遮挡、光线变化、透明物体反光、软物体形变,单一传感器很容易失效。
- 相机擅长语义识别、纹理理解,但测距容易受光照、反光干扰;
- 激光雷达抗光照干扰强,适合建图、避障、粗定位,但缺少物体类别语义;
- 腕部深度相机适合近距离操作定位,支撑抓取阶段精细视觉;
- 高频力传感器无法 “看见” 物体,但能感知接触、形变、装配松紧这类视觉看不到的物理状态;
- 语音阵列接收自然语言指令,建立人和机器人之间的语义交互通道。
多模态融合算法,就是把这些异构信息互补,弥补单一传感器缺陷。但做好融合实验有一个硬性前提:所有感知数据时间对齐、标定完成、输出规范。不少课题组自行组装传感器套件,后期需要手动做时间同步、外参标定,同步误差大,直接影响融合算法效果,实验结论可信度大打折扣。
行者 R1 Pro 出厂完成全套传感器内外参标定与时间同步,交付即可开展多模态感知融合研究。
二、行者 R1 Pro 全套感知硬件,多源传感器时序同步设计
行者 R1 Pro 整机尺寸 900×550×1620mm,底盘自重 150kg,额定载重 100kg,最高移动速度 1.8m/s,续航 4 小时,搭载多层安全防护,适配感知算法长时间采集测试。 整套感知套件由五类感知单元组成,统一时钟同步:
2.1 头部全局深度相机
RGB 分辨率 1280×800@30fps,深度最高 90fps,负责全局场景语义分割、目标检测、场景重建,适合机器人在移动阶段理解环境布局、识别目标物体。
2.2 腕部主动双目深度相机
1280×720@90fps,安装在机械臂末端,靠近操作点位,在抓取、装配、精细交互阶段提供近距离高精度深度信息,解决抓取时目标遮挡、视角受限问题。
2.3 360° 多线激光雷达
IP65 防护等级,输出稠密点云,支撑 SLAM 建图、全局定位、动态障碍物检测,不受暗光、暗光环境影响,和视觉形成互补。
2.4 双臂内置高频力扭矩传感器
采样频率 5kHz,力控精度 0.15N / 0.05N・m,实时记录每一次接触、挤压、装配过程中的力信号,捕捉视觉无法观测的物理交互状态。
2.5 多麦语音阵列
拾音距离最远 10m,声源定位精度 ±10°,支持中英语音识别,接收自然语言指令,打通语言语义与物理感知的链路。
所有传感器数据通过 ROS2 标准化话题输出,自带统一时间戳,不需要课题组自行开发同步程序,直接用于多模态数据集构建和融合算法训练。
三、感知到交互闭环:视觉、激光、力觉、语音协同联动
行者 R1 Pro 依托双软件架构,实现 “感知→推理→动作” 闭环: 在 ROS2 模块化架构下,可以灵活搭建多模态融合管线:激光雷达完成定位避障,全局相机检索目标,机器人移动靠近;腕部双目完成抓取前精准定位;接触瞬间力传感器反馈接触状态,调整臂体柔顺力度;语音模块接收新指令随时调整任务。
在 VLA 端到端架构下,多模态观测信息统一送入视觉语言动作大模型,模型同时理解图像、语言、接触状态,直接输出全身动作指令,研究端到端多模态具身策略。
配套全身遥操作系统在示教过程中,同步录制图像、点云、力曲线、语音、机器人位姿全套时序数据,一份数据集同时包含多种模态信息,非常适合多模态大模型训练。
四、适配多模态感知方向主流科研课题
- 多传感器融合定位与建图:视觉 - 激光融合 SLAM,动态环境下鲁棒定位研究;
- 视觉 - 力觉融合操作算法:基于图像和力反馈联合判断,柔性物体操作、装配策略;
- 多模态大模型感知对齐研究:图像、深度、力、文本跨模态表征学习;
- 双目近场感知与抓取位姿估计:腕部双目视觉,非结构化物体抓取检测;
- 语音驱动多模态人机交互:语音指令联动视觉感知、机器人操作任务;
- 遮挡场景下目标感知补全算法:多模态信息互补,解决单视觉遮挡失效问题。
五、R1 Pro 在感知实验上区别于普通科研机器人的优势
第一,双层双目视觉架构:头部全局视觉 + 腕部末端双目,兼顾场景级感知和操作级精细感知,是很多同类平台不具备的配置;
第二,原生统一时钟同步方案,降低多模态数据时间偏差,保证融合实验数据质量;
第三,力传感高频输出,不只是安全保护,而是作为感知模态参与算法输入,支持力觉感知方向研究;
第四,感知硬件可独立解耦调试,你可以单独调试某一路传感器算法,也可以开启全部模态做融合;
第五,和本地算力深度适配,多模态数据可以本地实时推理,避免大数据量传输带来的延迟和丢包。
六、多传感器采集与融合开发 FAQ
Q:多传感器之间的时间同步误差大概是多少?
A:底层硬件时钟同步,同步误差控制在毫秒级,满足多模态融合算法科研要求。
Q:是否可以单独采集某一类传感器数据,关闭其他感知源?
A:支持,ROS 节点可以单独启停,按需开启相机、激光、力传感、语音模块,灵活配置实验方案。
Q:相机、激光雷达外参标定文件是否交付?
A:出厂标定文件随 URDF、ROS 包一起交付,也支持课题组自主重新标定。
Q:力传感器数据可以和图像做帧对齐吗?
A:可以,统一时间戳,基于时间戳索引即可完成图像帧与力信号的对齐。
Q:能不能接入自研的多模态融合模型?
A:ROS 开放接口,感知话题标准,轻松接入自研融合算法、大模型推理服务。


